Prvá verzia asistenta odpovedala za 1,9 sekundy. V telefóne je to dlho: klient stihol povedať „haló?“ a asistent mu práve vtedy skočil do reči. Ľudia v rozhovore začínajú odpovedať zhruba do 200 ms od konca repliky[1]. Tam sa stroj nedostane, ale pod 800 ms to už pôsobí ako rozhovor, nie ako telefónne menu.
Kde sa míňal čas
Prvý krok bolo meranie. Každý krok reťazca som logoval zvlášť a z 50 testovacích hovorov zobral medián. Výsledok ma prekvapil:
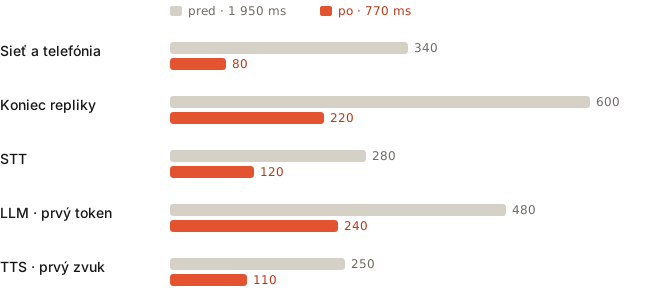
Jazykový model, ktorý som podozrieval ako prvý, nebol najväčší problém. Najviac času zjedlo čakanie na koniec repliky a hneď za ním sieť.
Najväčšie prekvapenie: sieť
SIP trunk bol v Bratislave, ale agent bežal v americkom regióne. Každé slovo klienta tak preletelo Atlantik a odpoveď sa vracala späť. Presun agenta do európskeho regiónu ušetril 250 ms bez jediného riadku kódu.
Pre telefonovanie sa za dobré jednosmerné oneskorenie považuje do 150 ms[2]. Ak ho mínaš len na cestu cez oceán, na modely ti nezostane nič.
Ako vyzerá reťazec
Hovor prichádza cez SIP do LiveKitu, kde ho v miestnosti čaká agent. Ten má tri modely za sebou a jazykový model si cez nástroje siaha do kalendára a ponuky makléra.
flowchart LR
  klient[Klient] --> sip[SIP trunk] --> lk[LiveKit] --> agent
  subgraph agent [agent · livekit-agents]
    direction TB
    stt[STT · prepis] --> llm[LLM + nástroje]:::akcent --> tts[TTS · hlas]
  end
  agent <--> nastroje
  subgraph nastroje [nástroje]
    direction TB
    kal[Kalendár] ~~~ pon[Ponuka]
  end
Streaming všade
Zvyšok času som získal tým, že žiadny krok nečaká na celý výsledok toho predchádzajúceho:
- STT posiela priebežný prepis, kým klient ešte hovorí.
- Detektor konca repliky je model, nie pevné ticho[3]. Pozná, že „na Petržalke, eee…“ ešte nie je koniec.
- LLM začne generovať špekulatívne, ešte kým sa čaká na potvrdenie konca repliky.
- TTS hovorí prvú vetu, kým model píše druhú.
session = AgentSession(
    stt=stt,                            # streamovaný prepis
    llm=llm,
    tts=tts,
    vad=silero.VAD.load(),
    turn_detection=MultilingualModel(), # model namiesto ticha
    preemptive_generation=True,         # generuj skôr, než klient dohovorí
)
Pri STT som skúšal aj model Whisper, ktorý sa učil na 680 000 hodinách nahrávok[4].
Na slovenčinu je výborný, ale dávkový, takže na telefón je pomalý. Viac v článku
Slovenčina v STT. Nastavenie sa dá prepnúť aj
priamo v AgentSession.
Výsledok
Z 1 950 ms na 770 ms. Najviac pomohlo presunúť server a vymeniť ticho za model na detekciu konca repliky. Rýchlejší jazykový model bol až tretí v poradí.
Zdroje
- STIVERS, Tanya a kol. Universals and cultural variation in turn-taking in conversation. PNAS. 2009, roč. 106, č. 26, s. 10587–10592.doi:10.1073/pnas.0903616106↩
- ITU-T. Recommendation G.114: One-way transmission time. Ženeva: ITU, 2003.itu.int/rec/T-REC-G.114↩
- LIVEKIT. Turn detection and interruptions [online]. LiveKit Agents docs, 2026 [cit. 2026-10-14].docs.livekit.io/agents↩
- RADFORD, Alec a kol. Robust Speech Recognition via Large-Scale Weak Supervision. arXiv. 2022.arXiv:2212.04356↩